Hồi bé tớ bị lạc ở Hồng Kông. Tớ không nói được tiếng ở đó.
Những chuyến đi sau này, sang Trung Quốc và những nước khác mà tớ không biết tiếng, tớ không dùng được mạng di động. Lần nào tớ cũng ước đúng một thứ: một công cụ dịch không cần mạng, để tớ hiểu người ta và nói chuyện được với họ.
Knowless là lần tớ thử làm ra thứ đó. Nó chuyển lời nói thành chữ và bản dịch trực tiếp, ngay trên điện thoại. Tớ thiết kế nó, rồi làm ra bằng các công cụ có AI hỗ trợ.1 Có lẽ đây là app đơn giản nhất tớ từng làm: một màn hình và một nút. Để nó đơn giản được như vậy, tớ đi sai đường ba lần.
Lần thử đầu: radar
Bản đầu tiên là một cái radar lúc nào cũng nghe. Tớ hình dung chỉ cần âm thanh là nó biết người nói đang ở đâu.
Không lâu sau tớ biết là nó không làm được. Điện thoại của tớ ghi âm không ra âm thanh không gian, nên trong bản ghi chẳng có gì cho biết giọng nói đến từ hướng nào. Theo tớ đọc được thì máy đời mới hơn có thể có. Tớ không có máy đó. Tớ thôi, không cố làm bằng âm thanh nữa.
Lần thử thứ hai: cả hai camera
Nên tớ thử dùng mắt thay cho tai. Camera trước và camera sau chạy cùng lúc, tìm khuôn mặt đang nói, để app biết người đó ở đâu.
Tớ làm tới mức có một bản chạy được trên điện thoại của tớ, mọi thứ nằm trên máy, không có server: nó nhìn qua cả hai camera và cố ghép từng giọng nói với một khuôn mặt. Nó hỏng ở đúng chỗ quan trọng. Điện thoại nóng lên. Pin tụt nhanh. Máy đơ, mà đơ suốt. Tớ bỏ nốt cách đó.
Nghe bằng chính tai tớ
Có những quyết định nhỏ hơn mà quan trọng không kém. Trên lý thuyết, khử ồn cho những nơi ồn ào nghe có vẻ hợp lý. Rồi tớ nghe một đoạn ghi âm ồn bằng chính tai tớ. Chính tớ nói gì tớ còn không nghe ra. Khử ồn đến mấy cũng không cứu được, nên tớ bỏ ý tưởng đó.
Đó là ý tớ khi nói “human in the loop”. Tớ làm app với AI, và tớ phải liên tục kiểm tra xem điều tớ đang yêu cầu có hợp lý trong tình huống thật không. Phần quyết định cực kỳ quan trọng.
Với các model cũng vậy. Tớ thử từng cái một, mất nhiều thời gian. Hồi đầu, với các model tải về điện thoại, app tính ra nặng khoảng bốn gigabyte. Prototype đầu tiên còn lưu cả lịch sử hội thoại. Tớ cắt phần đó để kịp ra mắt cho Shipaton, mà vẫn suýt lỡ deadline.
tớ còn không nghe ra thì chẳng bộ khử ồn nào nghe ra
Những gì còn lại
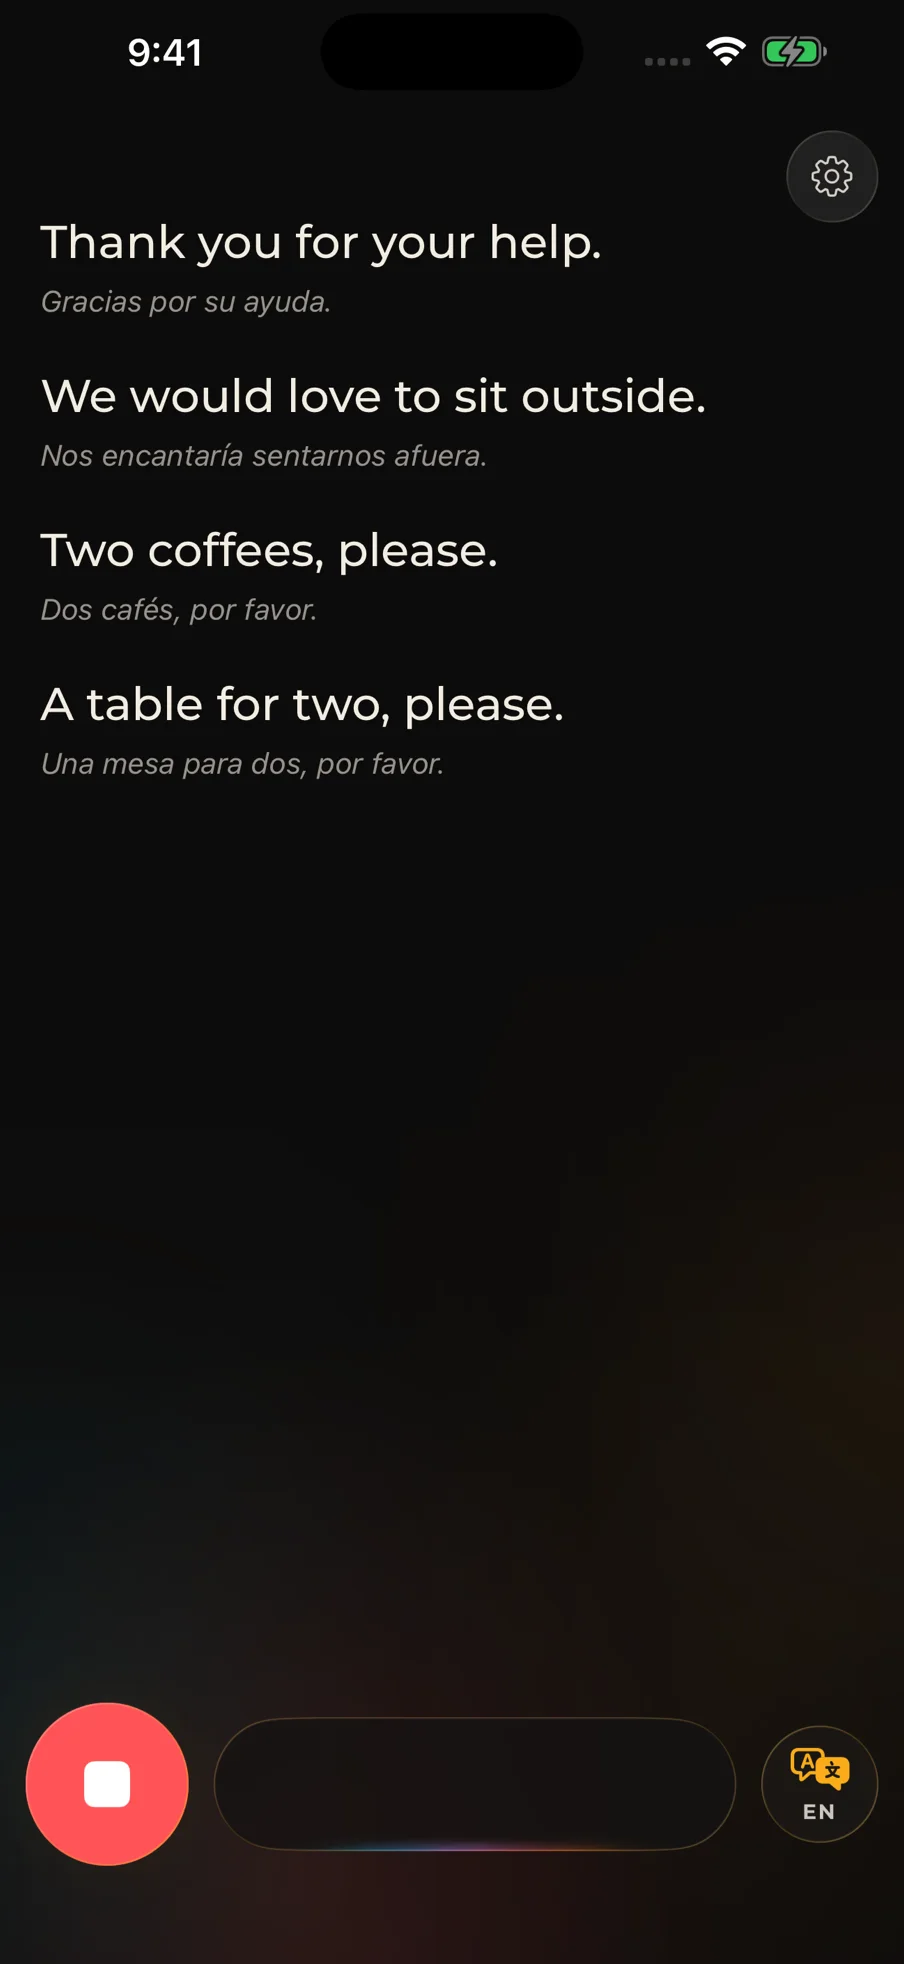
Một màn hình và một nút. Bấm, nói, dịch.
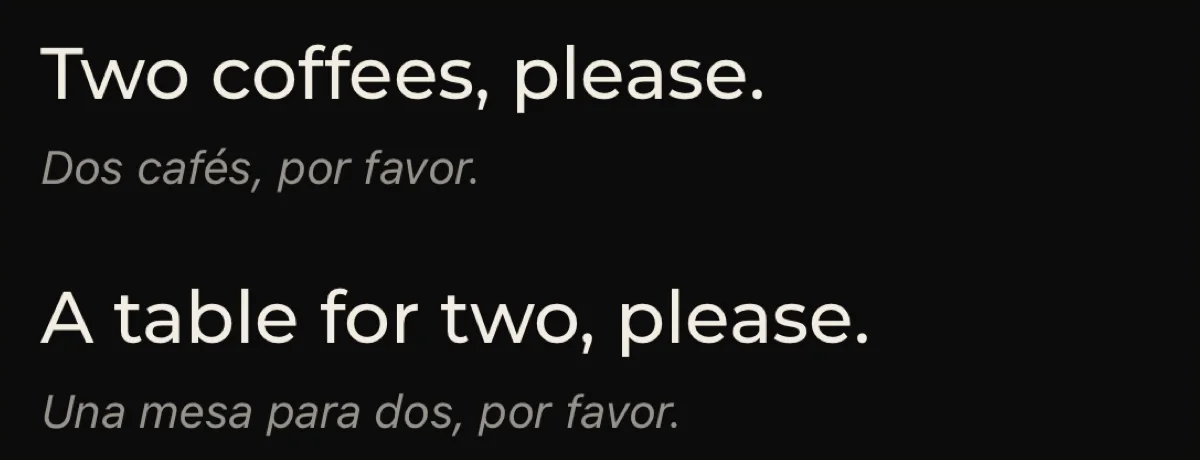
Dòng dịch thì to. Câu gốc nằm ngay bên dưới: nhỏ hơn, màu xám, chữ nghiêng.
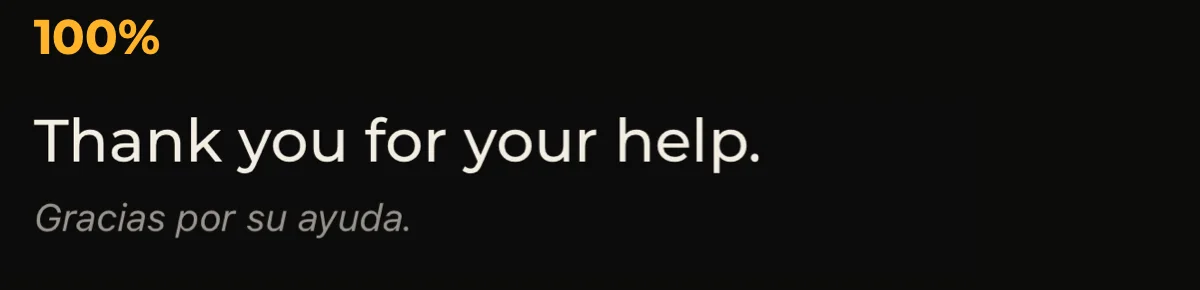
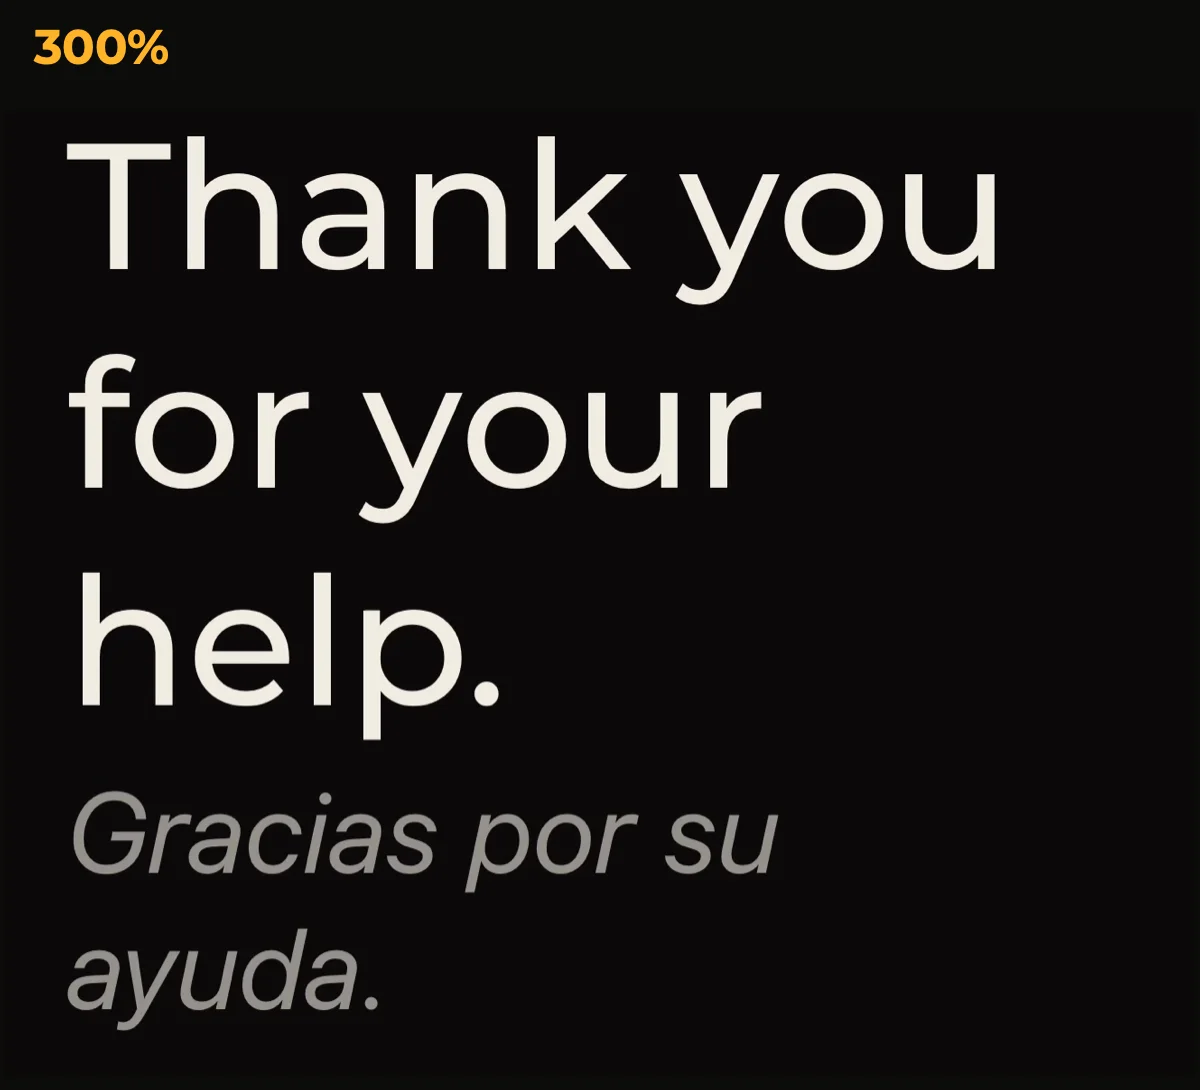
Chữ to lên thì thứ tự đó vẫn giữ nguyên. Chụm hai ngón tay là chỉnh được cỡ chữ, từ 50% đến 300%. Ngôn ngữ để nghe thì chọn sẵn từ trước, nhiều nhất là ba. Và bạn có thể mang một dòng đi: copy nó, hoặc cho máy đọc thành tiếng.
Hai ngày đó
Một tính năng rất nhỏ hóa ra lại cực kỳ phức tạp: chữ hiện ra thế nào.
Trông thì như âm thanh thành chữ, rồi chữ lên màn hình. Không phải thế. Âm thanh thành một câu đoán, và câu đoán đó lên màn hình ngay, nên mới có cảm giác trực tiếp. Rồi câu đoán được sửa, và nếu bản sửa khác đi thì màn hình đổi theo. Hết một câu dài lại có thêm một lượt sửa nữa, dựa vào ngữ cảnh của cả câu.
Từng trạng thái đó đều phải trông cho đúng, và quãng chờ ở giữa cũng vậy. Dòng nào còn đang tới thì hiện thành những ký tự đổi liên tục, nằm sau một con trỏ màu hổ phách. Dòng đã chốt là chữ bình thường, và nó đứng yên.
Tớ chạy đi chạy lại giữa app và bản mock-up design hơn hai ngày. Ngay từ đầu tớ biết tớ muốn nó trực quan, và tớ tin mọi người sẽ thấy thế. Tớ không ngờ lại mất lâu đến vậy.
có những thứ không nên ở đó. không phải ai cũng nhận ra.
Có sao nói vậy
Nhận diện giọng nói và dịch đều chạy trên điện thoại. Ngôn ngữ thì phải tải về một lần, lúc có mạng. Sau đó phần chính chạy được mà không cần mạng. Thế nên tấm ảnh chụp màn hình tớ chuẩn bị cho App Store ghi “works offline” và nói liền một hơi cả điều kiện: sau khi tải các ngôn ngữ được hỗ trợ.
Những gì bài này không chứng minh
Ở đây không có kết quả nào: không điểm đo mức độ hiểu, không nghiên cứu usability, không số liệu về lượng người dùng. Cái tớ cho bạn xem được là con đường tớ đã đi, và nó dẫn tới đâu.
Tiếp theo tớ muốn hai người, mỗi người một điện thoại, nói chuyện với nhau qua bản dịch trực tiếp. Cái đó tớ chưa làm.