Kiedy byłem mały, zgubiłem się w Hongkongu. Nie znałem języka.
Podczas późniejszych podróży, do Chin i do innych krajów, których języka nie znam, nie mogłem korzystać z internetu mobilnego. Za każdym razem brakowało mi tego samego: tłumacza, który nie potrzebuje połączenia, żebym mógł rozumieć ludzi i z nimi rozmawiać.
Knowless to moja próba zrobienia czegoś takiego. Zamienia mowę w transkrypcję i tłumaczenie na żywo, w samym telefonie. Zaprojektowałem go i zbudowałem za pomocą narzędzi wspomaganych przez AI.1 To chyba najprostsza aplikacja, jaką zrobiłem: jeden ekran i jeden przycisk. Zanim stała się tak prosta, trzy razy poszedłem w złą stronę.
Pierwsza próba: radar
Pierwsza wersja była radarem, który cały czas słuchał. Wyobrażałem sobie, że po samym dźwięku rozpozna, gdzie jest ten, kto mówi.
Szybko się okazało, że nie potrafi. Nagranie z mojego telefonu nie ma dźwięku przestrzennego, więc nic w nim nie mówi, skąd dochodzi głos. Z tego, co czytałem, nowszy model być może to potrafi. Takiego nie mam. Dałem sobie spokój z dźwiękiem.
Druga próba: obie kamery
Spróbowałem więc oczu zamiast uszu. Przednia i tylna kamera włączone naraz, szukające twarzy, która mówi, żeby aplikacja wiedziała, gdzie ta osoba jest.
Doszedłem do działającej wersji na moim telefonie, ze wszystkim na urządzeniu i bez serwera: patrzyła przez obie kamery i próbowała dopasować każdy głos do twarzy. Zawiodła w tym, co najważniejsze. Telefon się grzał. Bateria szybko się rozładowywała. Wszystko się zawieszało, często. Z tego też zrezygnowałem.
Słuchanie na własne uszy
Niektóre decyzje były mniejsze, a znaczyły tyle samo. Na papierze redukcja szumów w głośnych miejscach brzmiała rozsądnie. Potem posłuchałem zaszumionego nagrania na własne uszy. Nie mogłem zrozumieć, co sam mówię. Tego żadne odszumianie nie naprawi, więc porzuciłem ten pomysł.
To właśnie rozumiem przez „human in the loop”. Buduję z AI i muszę stale sprawdzać, czy to, o co proszę, ma sens w prawdziwej sytuacji. Decyzje są wyjątkowo ważne.
Z modelami było tak samo. Testowałem je po kolei, co trwało długo. Na początku, z modelami pobranymi na telefon, aplikacja zajmowałaby około czterech gigabajtów. Pierwszy prototyp zapisywał też historię rozmów. Wyciąłem to, żeby zdążyć z wydaniem na Shipaton, a i tak o mało nie przekroczyłem terminu.
jeśli ja nie słyszę, żaden filtr nie usłyszy
Co zostało
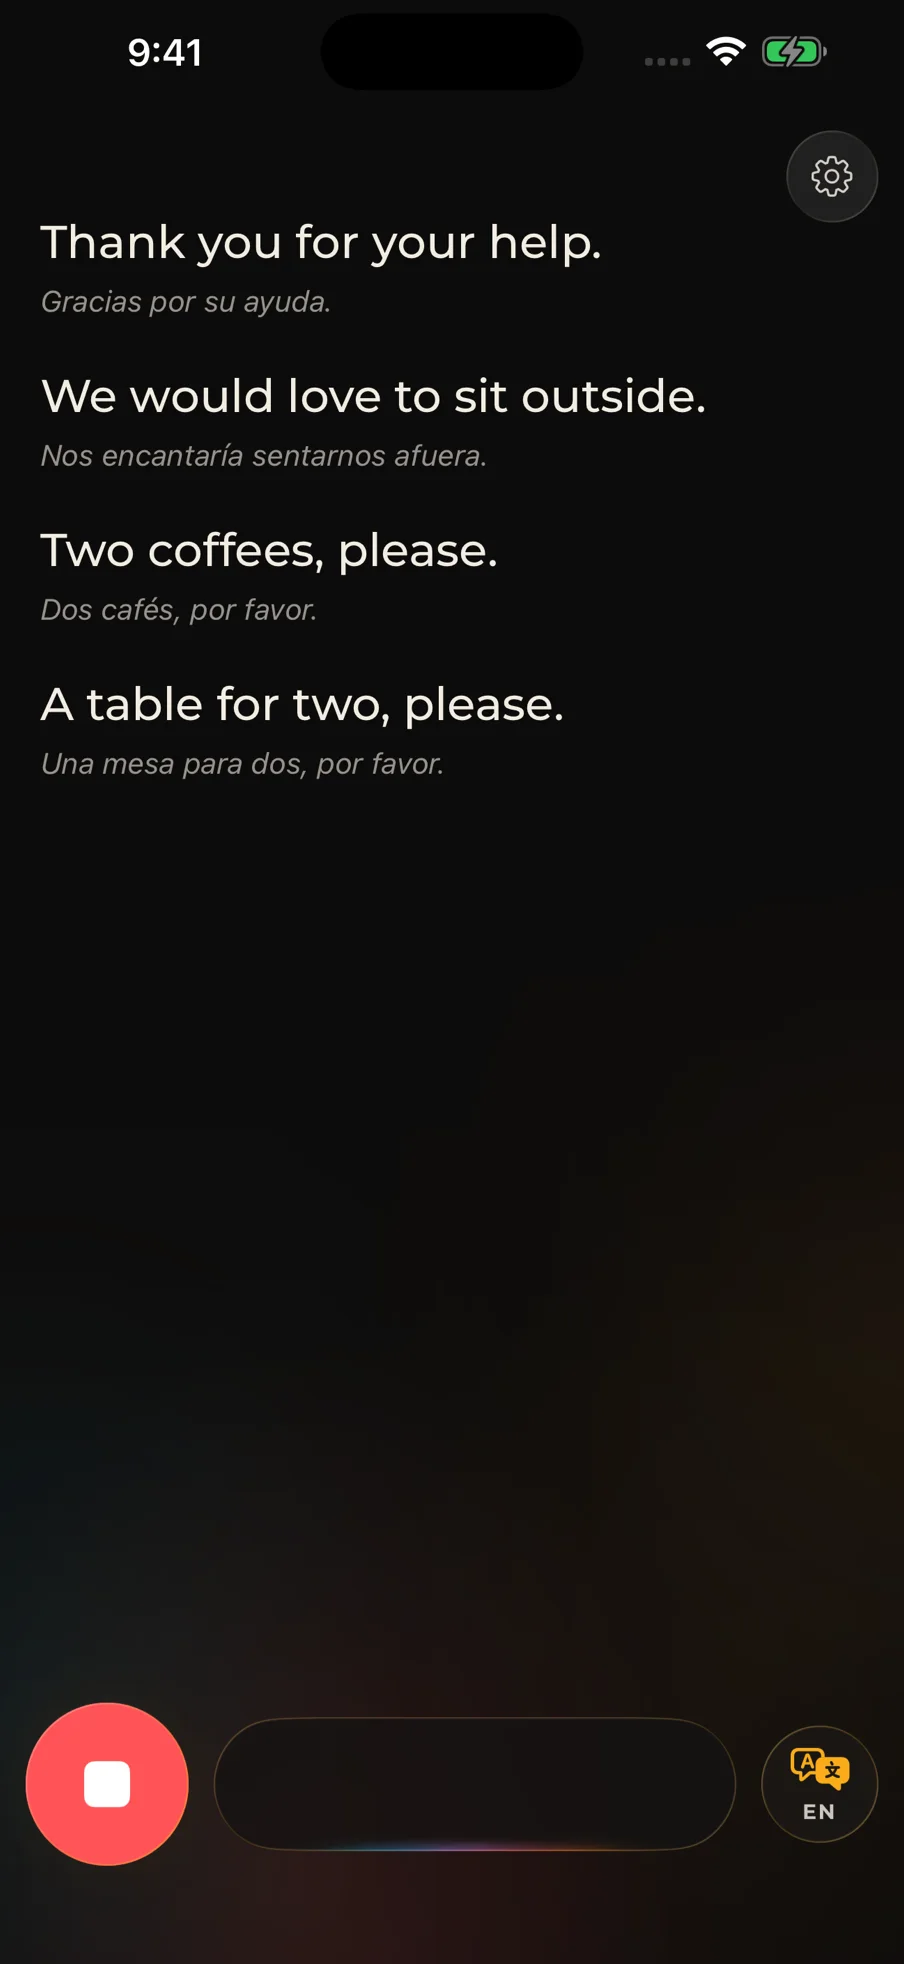
Jeden ekran i jeden przycisk. Naciśnij, mów, tłumacz.
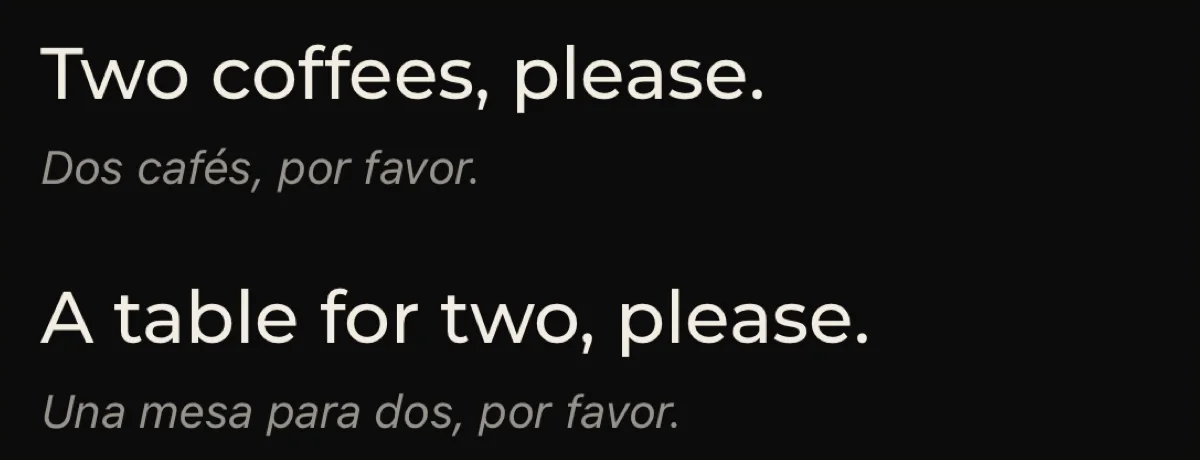
Przetłumaczona linijka jest duża. Oryginał jest tuż pod nią: mniejszy, szary, kursywą.
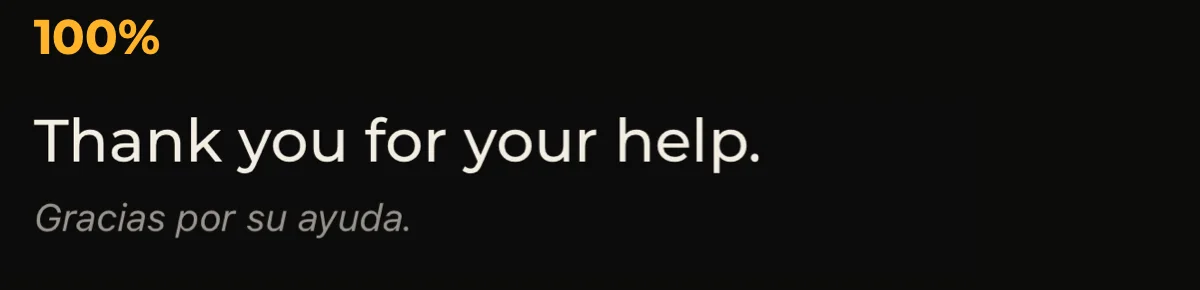
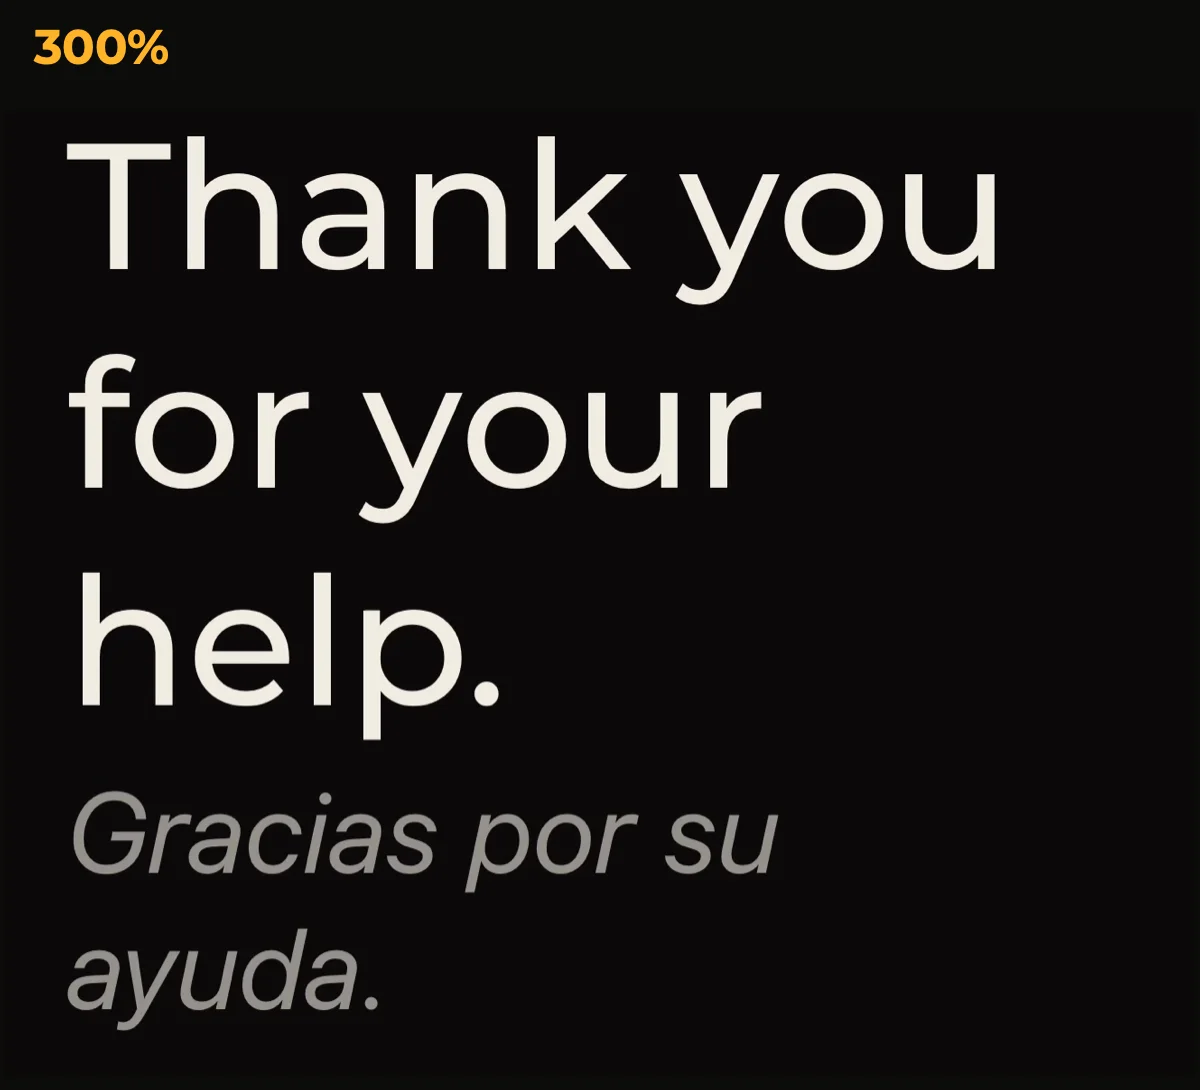
Kiedy tekst rośnie, kolejność zostaje ta sama. Tekst skaluje się od 50% do 300%, wystarczy zsunąć lub rozsunąć palce. Języki słuchania, najwyżej trzy, wybiera się z góry. A linijkę możesz zabrać ze sobą: skopiować albo kazać odczytać na głos.
Te dwa dni
Bardzo mała funkcja okazała się wyjątkowo skomplikowana: to, jak pojawiają się słowa.
Wygląda to tak, jakby dźwięk stawał się tekstem, a tekst trafiał na ekran. Tak nie jest. Dźwięk staje się domysłem, a domysł od razu trafia na ekran, więc czuć, że to na żywo. Potem domysł jest poprawiany, a jeśli poprawka się różni, ekran się zmienia. Po długim zdaniu jest jeszcze jedno przejście, które poprawia je ponownie, korzystając z kontekstu całego zdania.
Każdy z tych stanów musi wyglądać jak należy, czekanie między nimi też. Linijka, która dopiero nadchodzi, jest rysowana jako zmieniające się znaki za bursztynowym kursorem. Linijka, która już się ustaliła, to zwykły tekst i się nie rusza.
Ponad dwa dni krążyłem między aplikacją a makietą. Od początku wiedziałem, że ma być intuicyjne, i wierzyłem, że ludzie to poczują. Nie spodziewałem się, że zajmie to tyle czasu.
niektórych rzeczy nie powinno tam być. nie każdy to zauważa.
Mówić dokładnie tak, jak jest
Rozpoznawanie mowy i tłumaczenie działają na telefonie. Języki trzeba raz pobrać, kiedy jest połączenie; potem to, co najważniejsze, działa bez niego. Dlatego zrzut ekranu, który przygotowałem do App Store, mówi „works offline” i jednym tchem podaje warunek: po pobraniu obsługiwanych języków.
Czego to nie dowodzi
Nie ma tu wyników: żadnych miar zrozumienia, żadnego badania użyteczności, żadnych danych o liczbie użytkowników. Mogę pokazać drogę i to, dokąd doprowadziła.
W następnym kroku chcę, żeby dwie osoby, każda ze swoim telefonem, rozmawiały ze sobą przez tłumaczenie na żywo. Tego jeszcze nie zbudowałem.