Quando eu era pequeno, me perdi em Hong Kong. Eu não falava a língua.
Nas viagens seguintes, à China e a outros países onde não falo a língua, eu não conseguia usar dados móveis. Toda vez eu queria a mesma coisa: um tradutor que não precisasse de conexão, para eu entender as pessoas e conversar com elas.
O Knowless é a minha tentativa de fazer isso. Ele transforma fala em transcrição e tradução ao vivo, no próprio celular. Desenhei o app e construí com a ajuda de ferramentas de IA.1 Provavelmente é o app mais simples que já fiz: uma tela e um botão. Para ficar simples assim, errei o caminho três vezes.
Primeira tentativa: um radar
A primeira versão era um radar que ficava ouvindo o tempo todo. Imaginei que ele conseguiria dizer onde estava quem falava só pelo áudio.
Não demorei a descobrir que ele não conseguia. Meu celular não me dá áudio espacial a partir de uma gravação, então nada nela diz de onde vem uma voz. Pelo que li, um modelo mais novo talvez dê. Não tenho um. Parei de tentar fazer isso com som.
Segunda tentativa: as duas câmeras
Então tentei os olhos em vez dos ouvidos. Câmeras frontal e traseira ligadas ao mesmo tempo, procurando o rosto que estava falando, para o app saber onde essa pessoa estava.
Isso chegou a virar uma versão que funcionava no meu celular, com tudo no aparelho e sem servidor: ela observava as duas câmeras e tentava associar cada voz a um rosto. Falhou onde importa. O celular esquentava. A bateria acabava rápido. Travava, e muito. Desisti disso também.
Ouvindo com meus próprios ouvidos
Algumas decisões foram menores e importaram tanto quanto. No papel, redução de ruído para lugares barulhentos parecia razoável. Depois ouvi uma gravação barulhenta com meus próprios ouvidos. Não consegui entender o que eu mesmo estava dizendo. Não há redução de ruído que resolva isso, então desisti da ideia.
É isso que eu quero dizer com um humano no loop. Construo com IA, e tenho que conferir o tempo todo se o que estou pedindo faz sentido na situação real. As decisões são extremamente importantes.
Com os modelos foi a mesma coisa. Testei um por um, o que levou bastante tempo. No início, com os modelos baixados no celular, o app chegaria a cerca de quatro gigabytes. O primeiro protótipo também guardava um histórico de conversas. Cortei isso para lançar a tempo do Shipaton, e mesmo assim quase perdi o prazo.
se eu não consigo ouvir, filtro nenhum consegue
O que sobrou
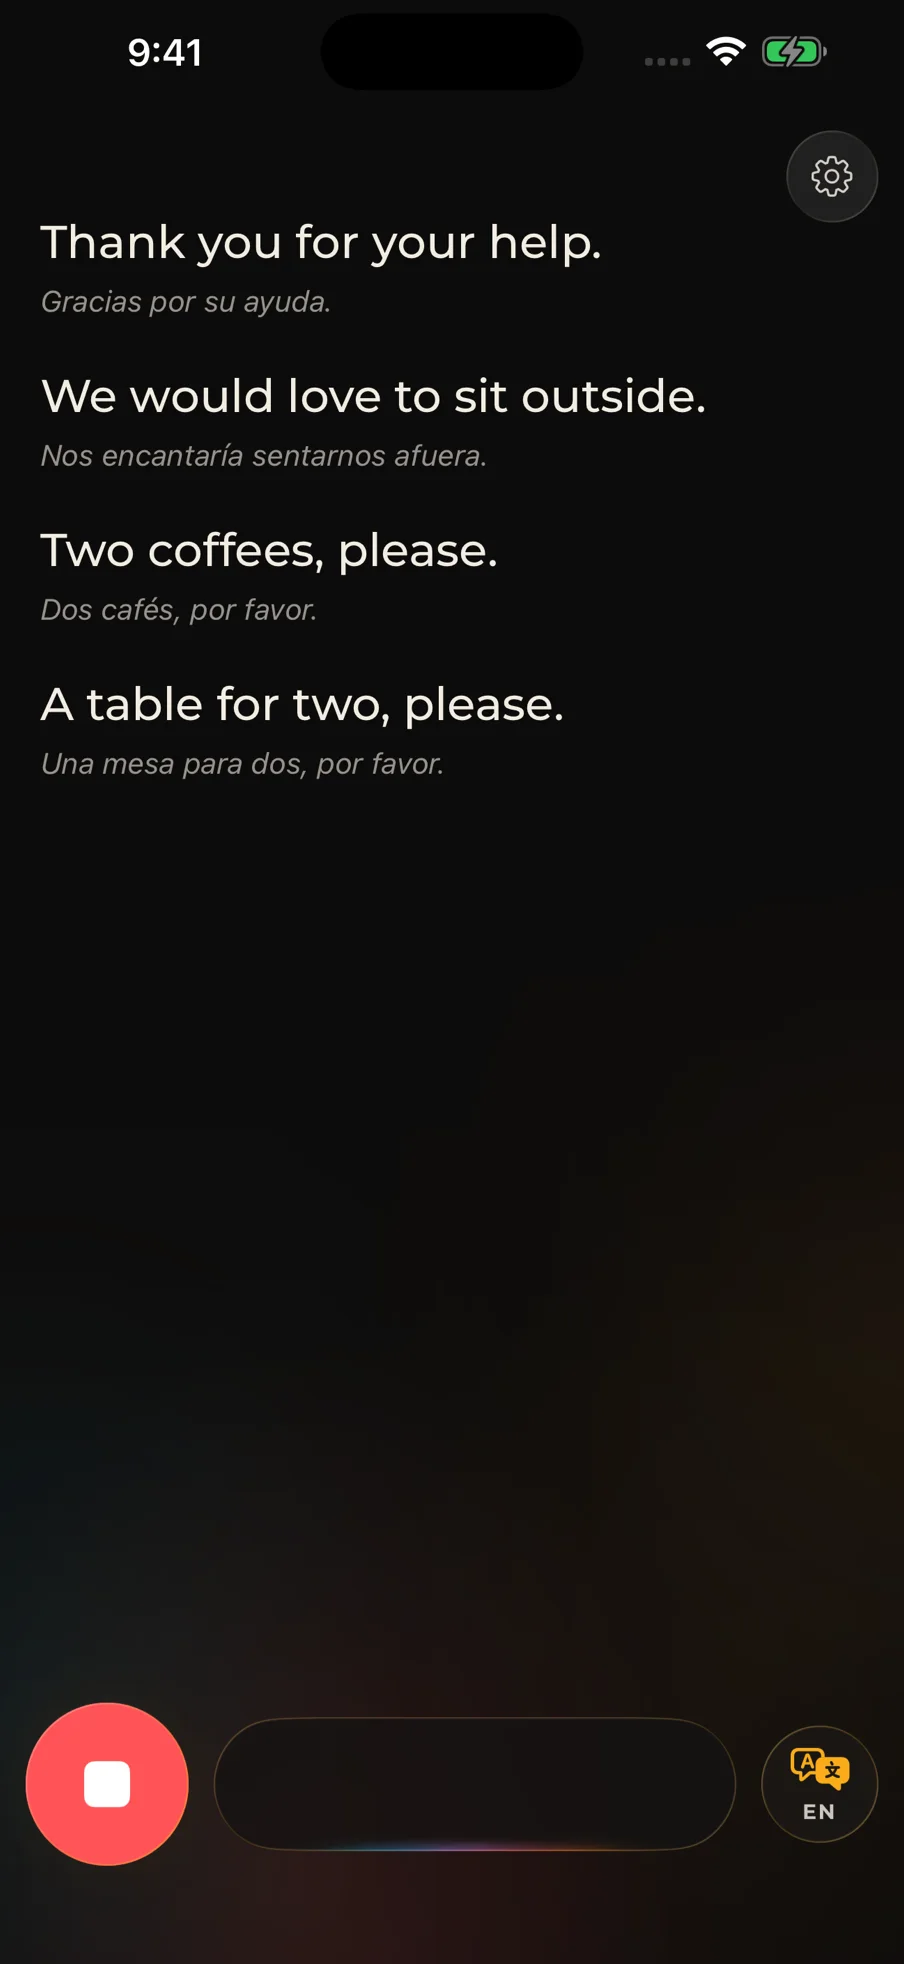
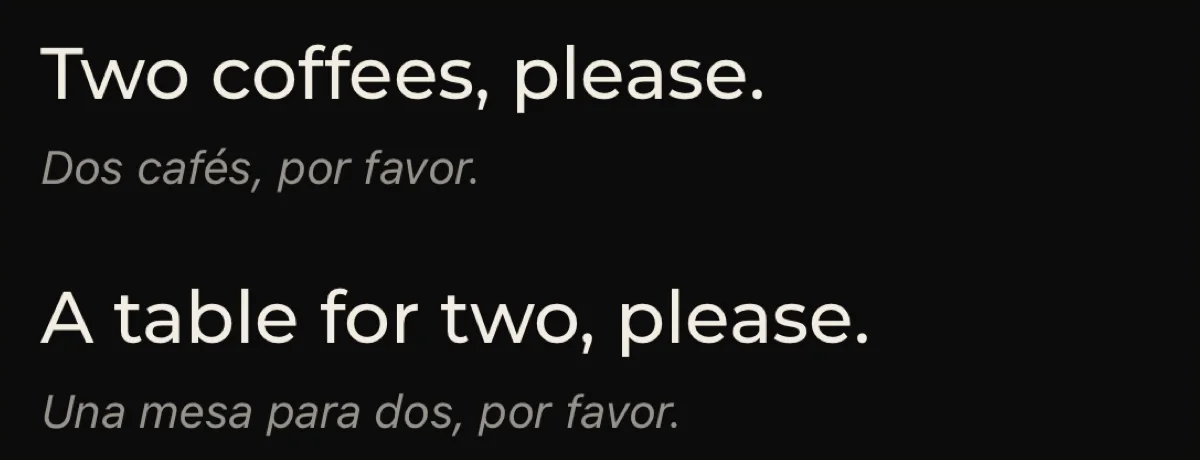
Uma tela e um botão. Apertar, falar, traduzir.
A linha traduzida é grande. O original fica logo abaixo: menor, cinza, em itálico.
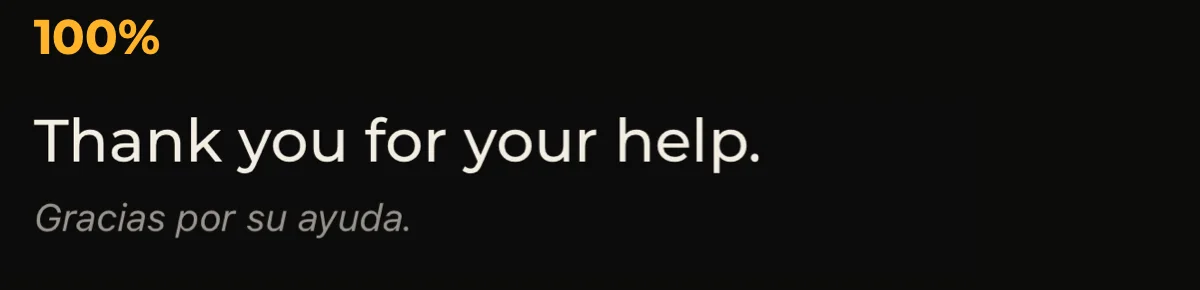
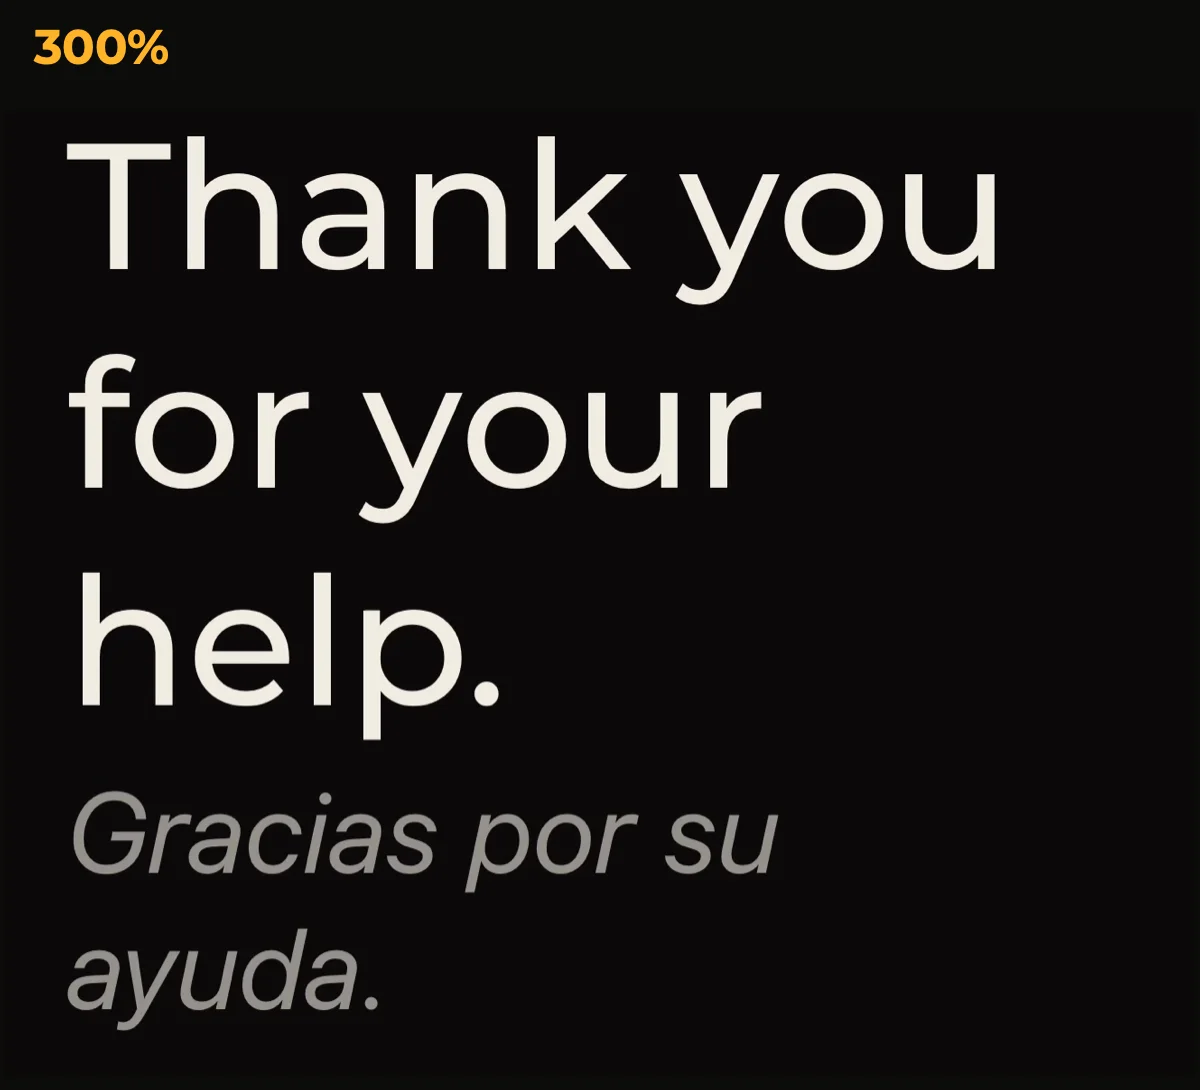
A ordem se mantém quando o texto cresce. Ele vai de 50% a 300% com um gesto de pinça. Os idiomas de escuta, até três, são escolhidos antes. E dá para levar uma linha com você: copiar, ou pedir para ler em voz alta.
Os dois dias
Um recurso bem pequeno acabou sendo extremamente complexo: como as palavras aparecem.
Parece que o áudio vira texto e o texto vai para a tela. Não é assim. O áudio vira um palpite, e o palpite vai para a tela na hora, por isso parece ao vivo. Em seguida o palpite é corrigido, e, se a correção for diferente, a tela muda. Depois de uma frase longa, há mais uma passada que corrige de novo, usando o contexto da frase inteira.
Cada um desses estados precisa parecer certo, e a espera entre eles também. Uma linha que ainda está chegando é desenhada como glifos que mudam, atrás de um cursor âmbar. Uma linha assentada é texto simples, e não se mexe.
Passei mais de dois dias indo e voltando entre o app e um mockup de design. Eu sabia desde o início que queria que fosse intuitivo, e acreditava que as pessoas iam sentir isso. Não esperava que fosse demorar tanto.
tem coisa que não devia estar ali. nem todo mundo percebe.
Dizer exatamente o que é verdade
O reconhecimento de fala e a tradução rodam no celular. Os idiomas precisam ser baixados uma vez, com conexão; depois disso, o essencial funciona sem ela. Por isso a captura de tela que preparei para a loja diz “works offline” e traz a condição junto: depois de baixar os idiomas compatíveis.
O que isso não prova
Não há resultados aqui: sem pontuações de compreensão, sem estudo de usabilidade, sem números de adoção. O que posso mostrar é o caminho, e onde ele foi dar.
Em seguida, quero duas pessoas, cada uma com um celular, traduzidas ao vivo uma para a outra. Isso ainda não foi construído.