小时候,我在香港走丢过。我不会说当地的话。
后来出门,去中国内地,去其他我不懂当地语言的国家,手机都用不了流量。每一次我想要的都是同一样东西:一个不用联网的翻译工具,让我能听懂别人,也能和他们说上话。
Knowless 就是我在这件事上的尝试。它直接在手机上把语音实时转写、翻译出来。我设计了它,也用 AI 辅助工具把它开发了出来。1它大概是我做过的最简单的 App:一个界面,一个按钮。为了做到这么简单,我走了三次弯路。
第一次尝试:雷达
第一版是一个一直在听的雷达。我设想它只靠声音就能判断说话的人在哪儿。
没过多久我就知道它做不到。我的手机录音拿不到空间音频,所以录音里没有任何信息能说明声音是从哪儿来的。就我读到的来看,新一点的机型也许可以。我没有那样的手机。我不再试着靠声音来做这件事。
第二次尝试:两个摄像头
于是我不用耳朵,改用眼睛。前后两个摄像头同时开着,找正在说话的那张脸,好让 App 知道那个人在哪儿。
这个方案做到了能在我手机上跑起来的程度,一切都在设备上,没有服务器:它盯着两个摄像头,试着把每个声音和一张脸对上。它败在了要紧的地方。手机发烫。电量掉得很快。卡死,而且经常卡死。这个方案我也放弃了。
用自己的耳朵听
有些决定小一些,分量却一样重。纸面上,给吵闹的地方做降噪,听起来很合理。后来我用自己的耳朵听了一段很吵的录音。连我自己在说什么,我都听不清。降噪做得再多也救不回来,所以我放弃了这个想法。
这就是我说的“人在回路”(human in the loop)。我用 AI 开发,就得不断检查,自己提的要求放在真实情境里到底合不合理。决策这一环极其重要。
模型也是一样。我一个一个地测,花了很长时间。早期的方案里,模型下载到手机上,整个 App 会达到大约 4 GB。第一版原型还保留着对话记录。为了赶上 Shipaton 按时上线,我把它砍了,结果还是差点错过截止日期。
我听不清的,什么滤波器也听不清
最后留下的
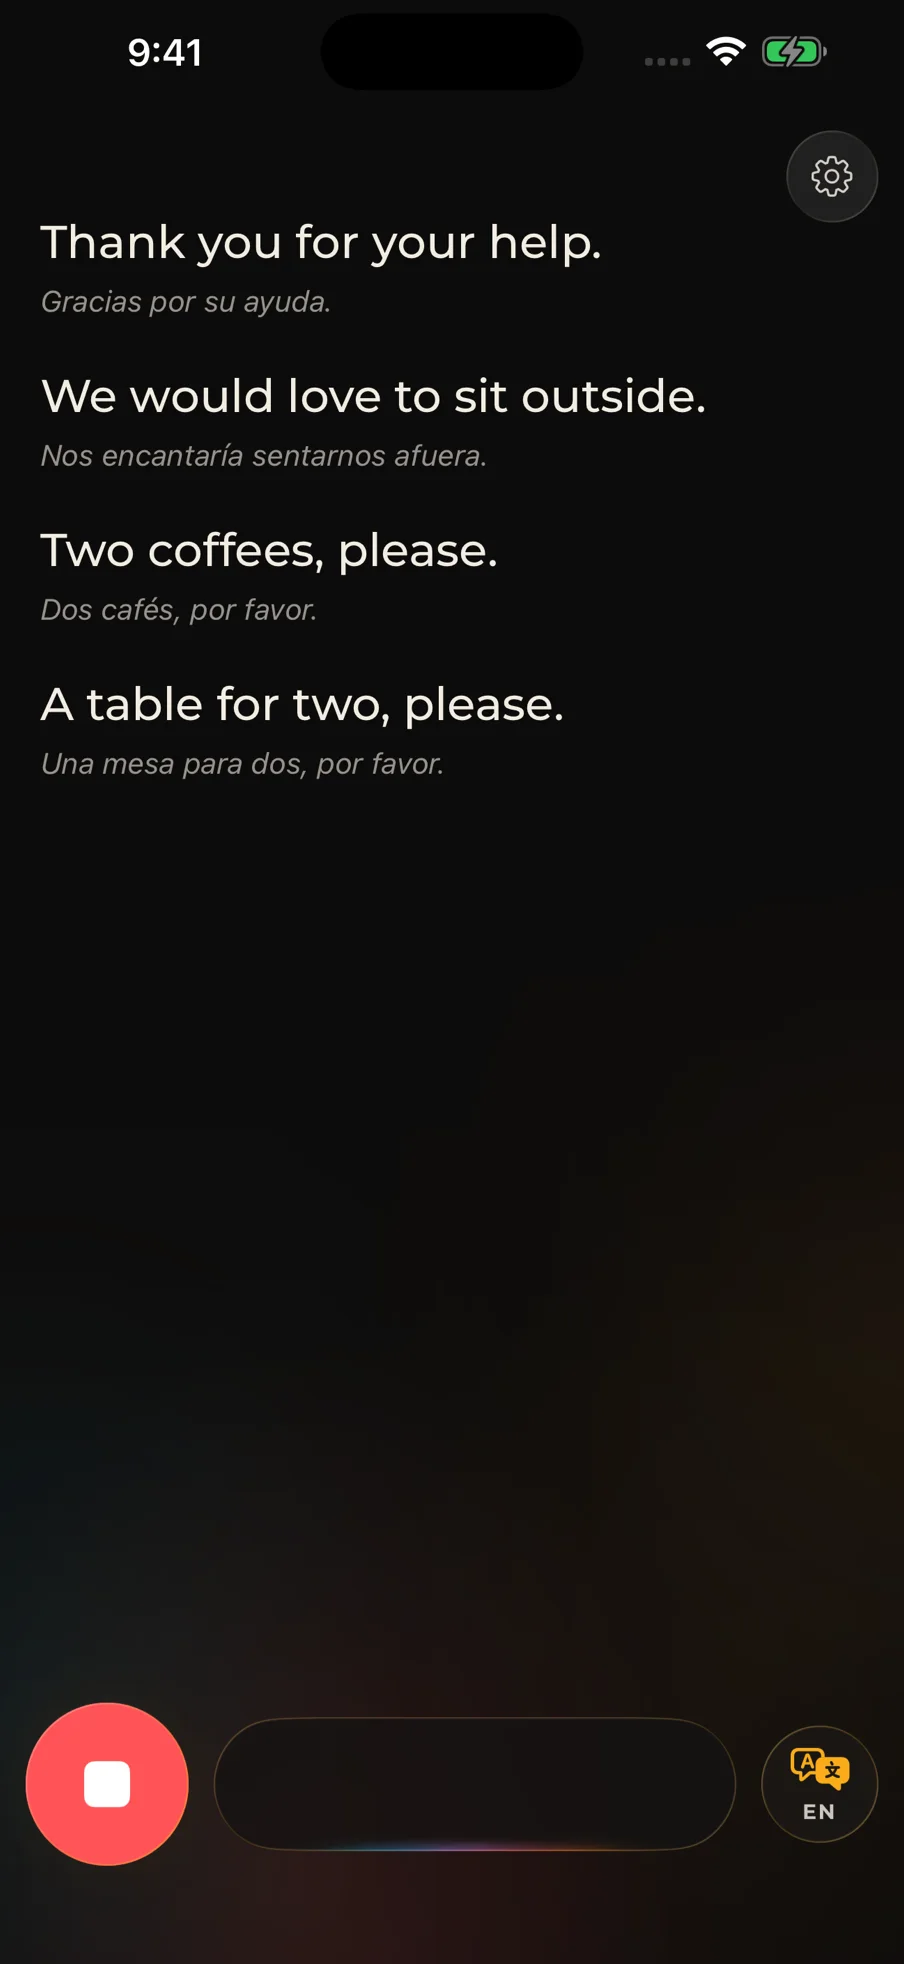
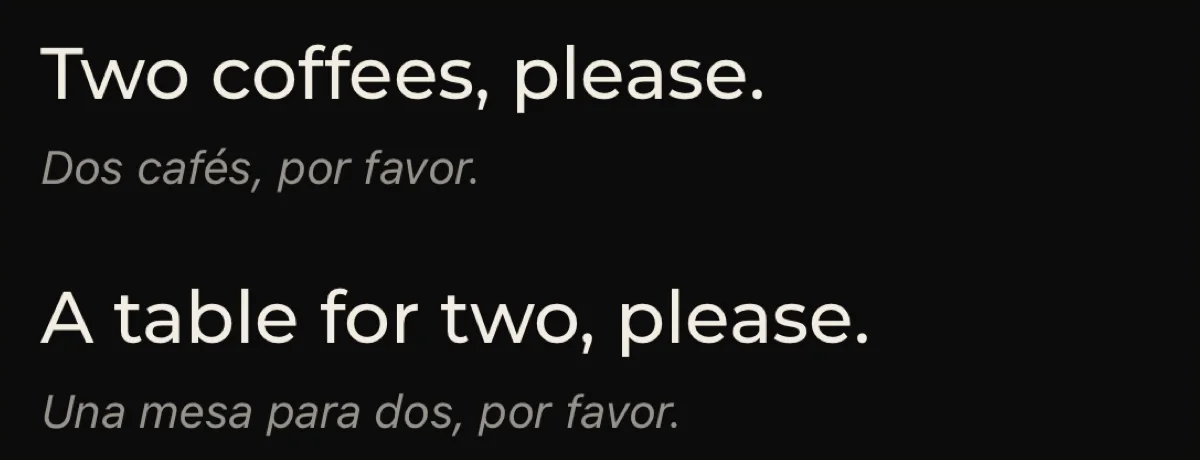
一个界面,一个按钮。按下,说话,翻译。
译文那一行字大。原文紧贴在它下面:小一些,灰色,斜体。
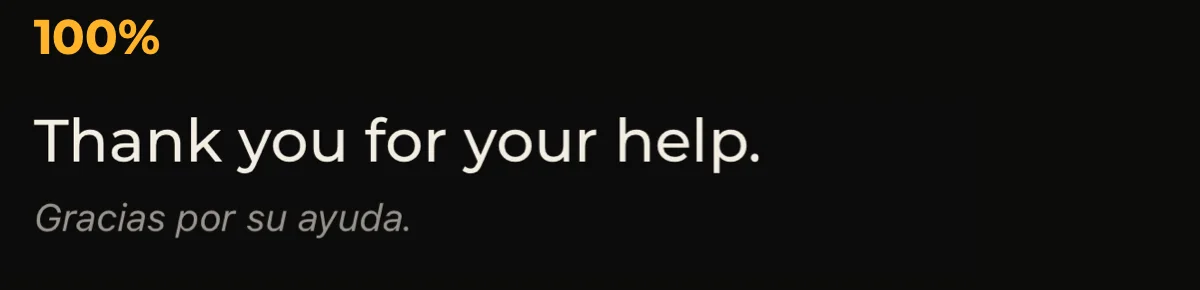
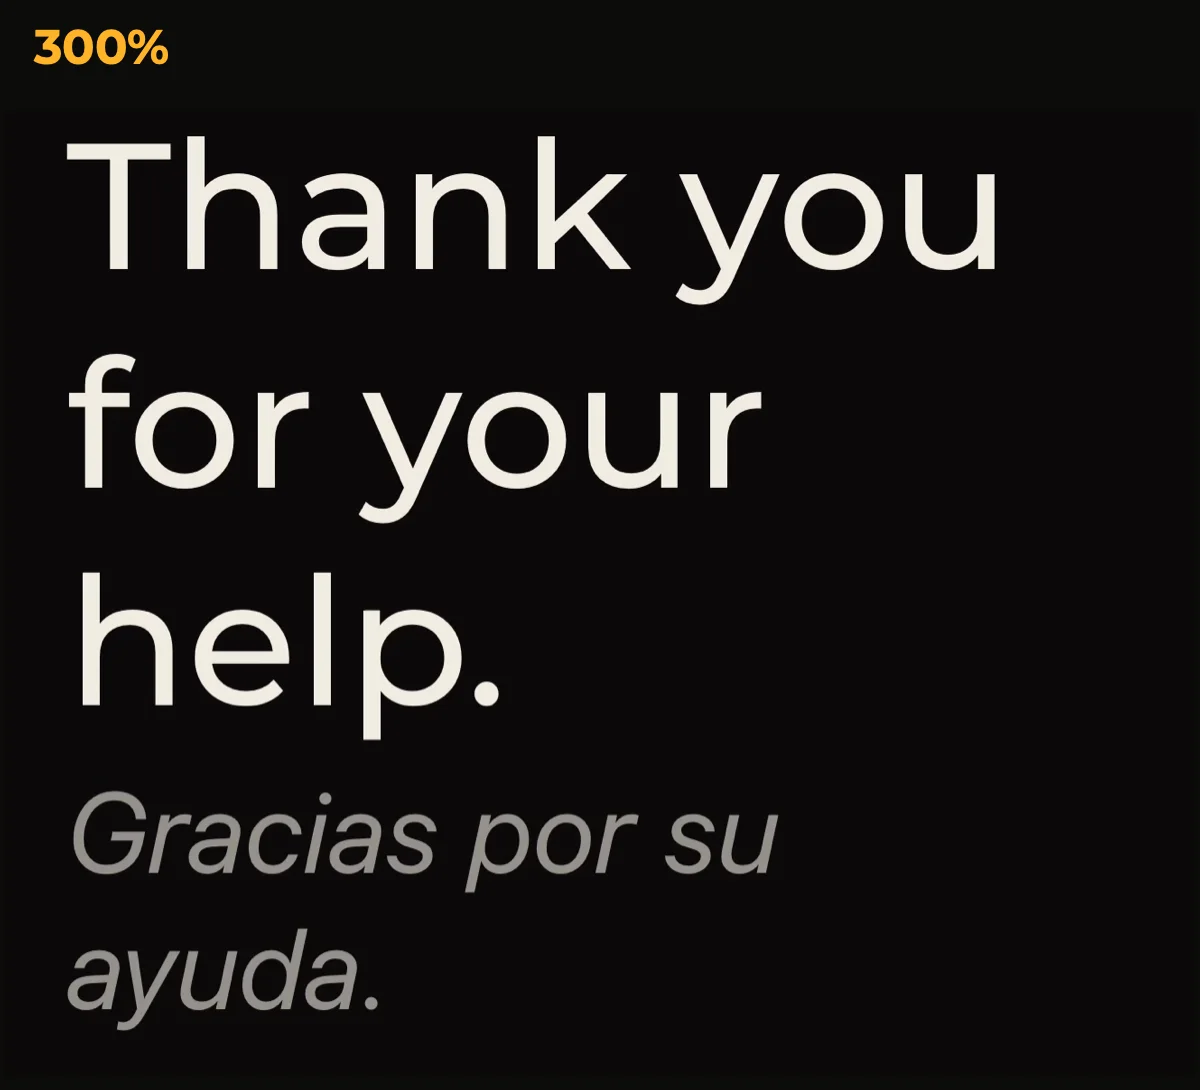
字放大了,这个顺序也不变。双指捏合就能缩放,从 50% 到 300%。要听哪些语言,事先选好,最多三种。你还可以把一行带走:复制它,或者让它朗读出来。
那两天
一个很小的功能,做起来却极其复杂:文字怎么出现。
看上去是音频变成文字,文字再显示到屏幕上。其实不是。音频先变成一个猜测,这个猜测立刻上屏,所以才有实时的感觉。接着再修正这个猜测,如果修正后不一样,屏幕上的字就跟着变。一个长句说完,还有一轮处理,结合整句的上下文再修正一次。
这几种状态,每一种都得看着对,中间等待的那一段也一样。正在出现的那一行,画成一串不断变化的字符,跟在琥珀色的光标后面。定下来的一行就是普通文字,不再动。
我在 App 和设计稿之间来来回回,花了两天多。从一开始我就知道,我想让它用起来符合直觉,也相信大家能感觉到。我没想到会花这么久。
有些东西不该在那儿。不是每个人都会注意到。
有一说一
语音识别和翻译都在手机上运行。语言需要先联网下载一次;之后,核心功能不联网也能用。所以我准备的商店截图上写着“works offline”(可离线使用),并且一口气把条件也带上:下载所支持的语言之后。
这里没有证明的事
这里没有成果数据:没有理解度评分,没有可用性研究,没有用户量数字。我能给你看的,是走过的这条路,和它最后通到了哪里。
下一步,我想让两个人各拿一部手机,互相实时翻译。这个还没做出来。